
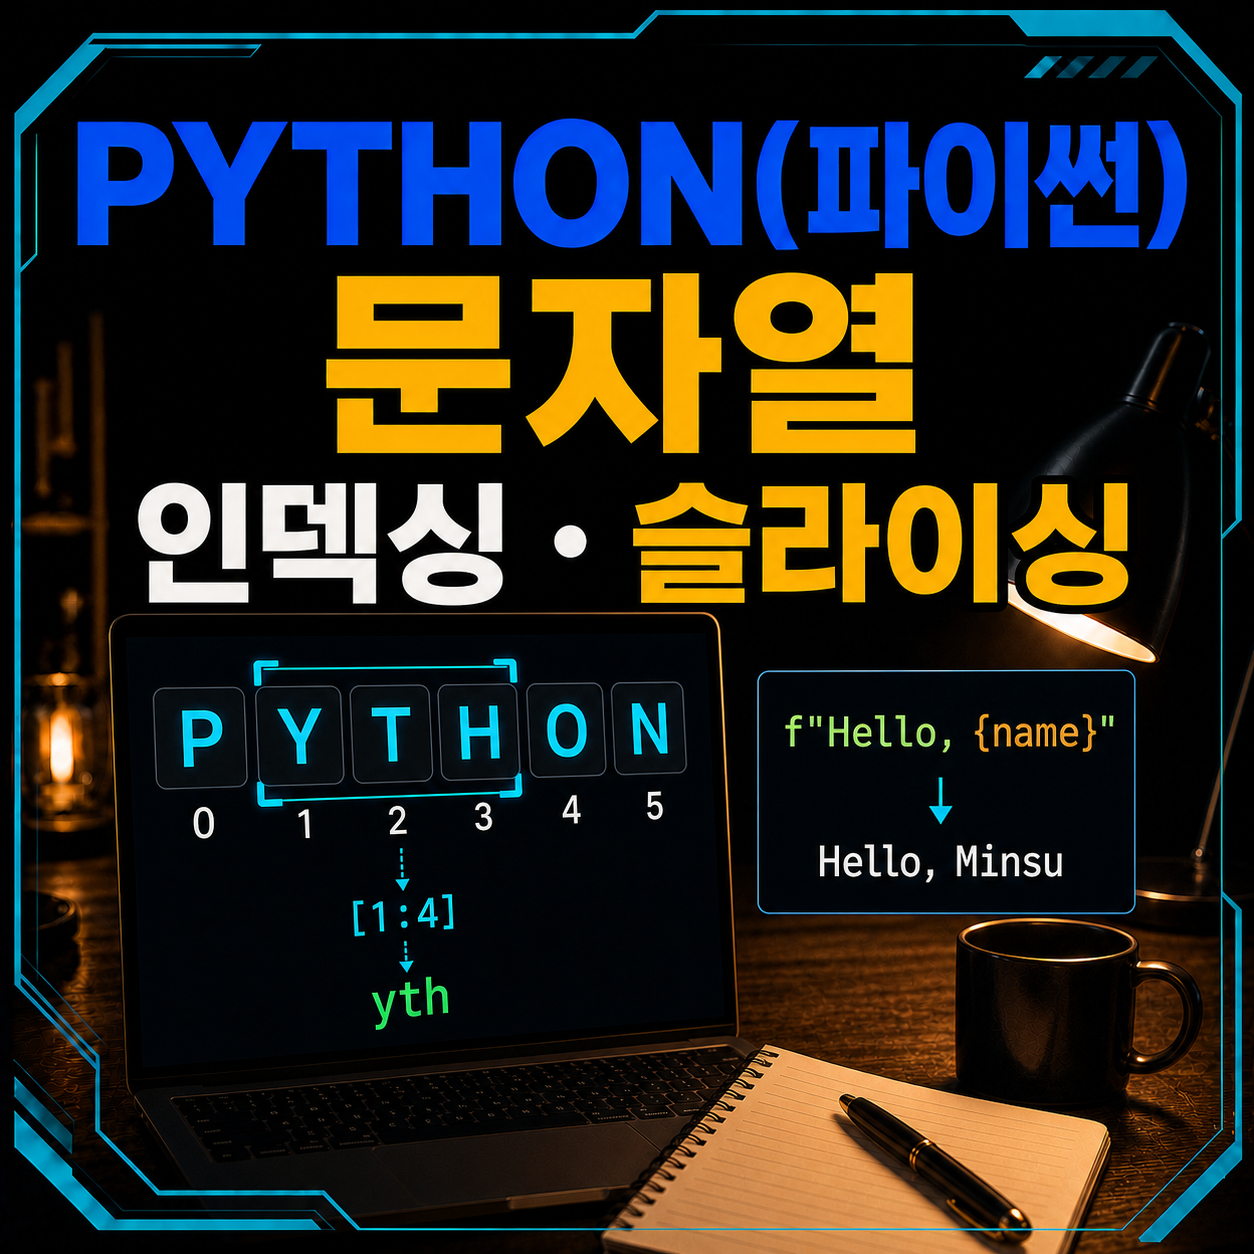
지난 글에서는 사용자가 "끝"을 입력할 때까지 반복하는 프로그램을 만들었습니다. 그때 입력받은 "끝", "공부", "1357" 같은 값은 모두 문자열입니다. 우리는 이미 문자열을 여러 번 사용했지만, 지금까지는 문장 전체를 하나의 값으로만 다뤘습니다.
예전에 문자열 인덱싱을 처음 배울 때는 왜 첫 글자가 1번이 아니라 0번인지, 슬라이싱의 끝 번호는 왜 포함하지 않는지가 유난히 헷갈렸습니다. 다시 살펴보니 글자 위에 번호를 붙이기보다 글자 사이의 경계에 번호를 붙인다고 생각하면 훨씬 이해하기 쉬웠습니다.
이번 글에서는 문자열 속 글자 하나를 찾는 인덱싱, 원하는 구간을 가져오는 슬라이싱, 문자열을 다듬는 메서드와 값을 문장 속에 넣는 f-string을 알아보겠습니다. 지난 글의 while문과 break·continue에서 사용한 입력값도 더 깔끔하게 처리해 보겠습니다.
문자열은 글자가 순서대로 이어진 값이다
문자열은 따옴표로 감싼 텍스트입니다.
message = "Python"
menu = "아메리카노"
empty_text = """Python"은 여섯 글자가 순서대로 이어진 문자열이고, ""은 글자가 하나도 없는 빈 문자열입니다. 파이썬에는 글자 하나만을 위한 별도의 문자형이 없습니다. "P"도 길이가 1인 문자열입니다.
문자열의 순서가 중요한 이유는 원하는 위치의 글자를 찾고, 앞부분이나 뒷부분만 가져오며, 한 글자씩 반복할 수 있기 때문입니다.
len()으로 문자열 길이 확인하기
len()은 문자열에 들어 있는 글자 수를 알려 주는 내장 함수입니다.
word = "Python"

print(len(word))
print(len("파이썬"))
print(len(""))6
3
0len("Python")은 6이고, len("파이썬")은 3입니다. 빈 문자열에는 글자가 없으므로 길이는 0입니다.
길이는 단순한 정보가 아닙니다. 입력값이 비어 있는지 확인하거나, 마지막 글자의 위치를 계산하거나, 글자 수를 제한할 때 사용할 수 있습니다.
nickname = input("별명을 입력하세요: ")

if len(nickname) == 0:
    print("별명이 비어 있습니다.")
else:
    print("별명 길이:", len(nickname))
인덱싱은 글자 한 자리를 찾는다
문자열 뒤에 대괄호를 붙이고 위치 번호를 적으면 해당 글자 하나를 가져올 수 있습니다. 이를 인덱싱이라고 합니다.
word = "Python"

print(word[0])
print(word[1])
print(word[5])P
y
n
첫 글자의 번호는 0이다
"Python"의 위치 번호를 펼치면 다음과 같습니다.
글자:   P  y  t  h  o  n
번호: 0 1 2 3 4 5첫 글자는 word[0], 두 번째 글자는 word[1]입니다. 일상에서는 첫 번째를 1이라고 세지만, 파이썬의 순서형 데이터는 첫 위치를 0부터 셉니다.
len(word)은 6이지만 마지막 글자의 번호는 5입니다. 길이는 글자의 개수이고, 인덱스는 0부터 시작하는 위치 번호이므로 마지막 인덱스는 len(word) - 1입니다.
음수 인덱스는 뒤에서부터 찾는다
마지막 글자를 가져오기 위해 항상 길이를 계산할 필요는 없습니다. 음수 인덱스를 사용하면 오른쪽에서부터 셀 수 있습니다.
word = "Python"

print(word[-1])
print(word[-2])
print(word[-6])n
o
P-1은 마지막 글자, -2는 뒤에서 두 번째 글자입니다. -0은 0과 같기 때문에 음수 인덱스는 -1부터 시작합니다.
없는 위치를 찾으면 IndexError가 발생한다
"Python"에 사용할 수 있는 양수 인덱스는 0부터 5까지입니다.
word = "Python"

print(word[6])이 코드를 실행하면 IndexError: string index out of range가 발생합니다. 문자열 범위를 벗어난 위치의 글자를 요청했기 때문입니다.
처음 인덱싱을 연습할 때 저도 문자열 길이를 마지막 인덱스로 착각해 word[len(word)]를 사용하곤 했습니다. 마지막 글자는 word[len(word) - 1] 또는 더 간단하게 word[-1]로 가져올 수 있습니다.
슬라이싱은 문자열의 구간을 가져온다
인덱싱이 글자 한 자리를 고른다면, 슬라이싱은 시작 위치부터 끝 위치 직전까지의 구간을 가져옵니다.
word = "Python"

print(word[0:2])
print(word[2:5])Py
thoword[0:2]는 0번부터 시작하지만 2번 글자는 포함하지 않습니다. 따라서 0번 P와 1번 y만 가져옵니다.
시작은 포함하고 끝은 포함하지 않는다
슬라이싱은 문자열[시작:끝] 형태이며 시작은 포함하고 끝은 제외합니다.
글자:   P   y   t   h   o   n
경계: 0 1 2 3 4 5 6글자 자체가 아니라 글자 사이의 경계에 번호가 붙었다고 생각해 보세요. word[1:4]는 1번 경계부터 4번 경계 전까지 잘라 "yth"를 만듭니다.
이 규칙 덕분에 가져온 글자 수는 끝 - 시작으로 계산할 수 있습니다. 또한 같은 경계에서 앞뒤를 나누면 원래 문자열을 다시 만들 수 있습니다.
word = "Python"

front = word[:3]
back = word[3:]

print(front)
print(back)
print(front + back)Pyt
hon
Python
시작이나 끝을 생략할 수 있다
시작을 생략하면 문자열의 처음부터, 끝을 생략하면 문자열의 마지막까지 가져옵니다.
word = "Python"

print(word[:2])
print(word[2:])
print(word[-3:])
print(word[:])Py
thon
hon
Pythonword[:]는 처음부터 끝까지 가져오므로 원래 내용과 같은 문자열을 만듭니다.
인덱싱과 슬라이싱은 범위 밖에서 다르게 동작한다
인덱싱은 없는 위치 하나를 요청하면 오류가 발생합니다. 반면 슬라이싱의 끝 범위가 문자열보다 커도 가능한 부분까지만 가져옵니다.
word = "Python"

print(word[4:100])
print(word[100:])on
word[4:100]은 4번부터 실제 끝까지인 "on"을 반환합니다. word[100:]은 가져올 글자가 없어 빈 문자열을 반환합니다.
이 차이는 인덱싱은 “그 자리에 있는 글자 하나”를 정확히 요구하지만, 슬라이싱은 “가능한 범위 안에서 이 구간”을 요청한다고 생각하면 이해하기 쉽습니다.
문자열은 만든 뒤 한 글자만 바꿀 수 없다
문자열은 변경할 수 없는 자료형입니다. 이를 불변이라고 합니다.
word = "Python"

word[0] = "J"이 코드는 TypeError를 발생시킵니다. 문자열 안의 0번 글자만 직접 교체할 수 없기 때문입니다.
내용을 바꾸고 싶다면 필요한 조각을 연결해 새 문자열을 만들어야 합니다.
word = "Python"
new_word = "J" + word[1:]

print(word)
print(new_word)Python
Jython원본 word는 그대로이고, new_word가 새로 만들어졌습니다. 문자열 메서드를 사용할 때도 이 원리가 이어집니다.
문자열 메서드는 새 문자열을 돌려준다
메서드는 특정 값이 사용할 수 있는 기능입니다. 문자열 뒤에 점을 찍고 메서드 이름과 괄호를 붙여 사용합니다.
text = "  Python Study  "

print(text.strip())
print(text.lower())
print(text.replace("Study", "Blog"))Python Study
python study
Python Blog strip(): 문자열 양끝의 공백을 제거한 새 문자열을 반환합니다.lower(): 영문 대문자를 소문자로 바꾼 새 문자열을 반환합니다.upper(): 영문 소문자를 대문자로 바꾼 새 문자열을 반환합니다.replace(기존, 새값): 지정한 부분을 바꾼 새 문자열을 반환합니다.
결과를 사용하지 않으면 원본은 그대로다
text = "  Python  "

text.strip()
print(text)출력에는 여전히 양끝 공백이 남아 있습니다. strip()이 원본을 직접 고친 것이 아니라 다듬어진 새 문자열을 반환했지만, 그 결과를 어디에도 저장하지 않았기 때문입니다.
text = "  Python  "
clean_text = text.strip()

print(clean_text)기존 변수에 다시 저장하고 싶다면 text = text.strip()처럼 작성할 수도 있습니다. 문자열 메서드를 사용한 뒤에는 “돌려받은 결과를 어디에 사용할까?”를 함께 확인해야 합니다.
지난 글의 입력값을 strip()으로 다듬기
지난 글에서는 사용자가 "끝" 앞뒤에 공백을 넣으면 다른 문자열로 판단한다고 설명했습니다. strip()을 사용하면 입력 양끝의 불필요한 공백을 먼저 제거할 수 있습니다.
while True:
    command = input("명령을 입력하세요(종료: 끝): ")
    command = command.strip()

    if command == "끝":
        break

    if command == "":
        print("내용을 입력해 주세요.")
        continue

    print("입력한 명령:", command)

print("프로그램을 종료합니다.")사용자가 " 끝 "을 입력해도 strip()의 결과는 "끝"이므로 종료 조건이 참이 됩니다. 앞에서 배운 입력, 조건문, 반복문과 문자열 메서드가 자연스럽게 연결됩니다.
문자열을 찾거나 확인하는 메서드
문자열에 특정 글자가 포함되어 있는지는 in으로 확인할 수 있습니다. 시작과 끝을 확인할 때는 startswith(), endswith()가 읽기 쉽습니다.
filename = "study.py"

print("study" in filename)
print(filename.startswith("study"))
print(filename.endswith(".py"))True
True
True이 기능들은 결과로 True 또는 False를 돌려주므로 조건문과 함께 사용하기 좋습니다.
filename = input("파일 이름을 입력하세요: ")

if filename.endswith(".py"):
    print("파이썬 파일입니다.")
else:
    print("확장자를 확인해 주세요.")
f-string은 값과 문장을 자연스럽게 연결한다
지금까지는 print()에 여러 값을 쉼표로 전달했습니다.
name = "민수"
score = 85

print(name, "님의 점수는", score, "점입니다.")f-string을 사용하면 문장 속 원하는 자리에 변수나 계산 결과를 넣을 수 있습니다. 따옴표 앞에 f를 붙이고, 값을 넣을 위치를 중괄호로 감쌉니다.
name = "민수"
score = 85

message = f"{name}님의 점수는 {score}점입니다."
print(message)민수님의 점수는 85점입니다.
중괄호 안에는 계산식도 넣을 수 있다
price = 4500
count = 3

print(f"{count}잔의 가격은 {price * count}원입니다.")3잔의 가격은 13500원입니다.중괄호 안의 price * count를 먼저 계산한 뒤 결과가 문자열에 들어갑니다. 다만 너무 긴 계산식을 모두 넣으면 문장이 읽기 어려워질 수 있으므로 복잡한 계산은 변수에 저장한 뒤 넣는 편이 좋습니다.
숫자 모양도 정할 수 있다
price = 13500
ratio = 0.8567

print(f"가격: {price:,}원")
print(f"달성률: {ratio:.1%}")가격: 13,500원
달성률: 85.7%{price:,}는 천 단위 쉼표를 표시하고, {ratio:.1%}는 백분율을 소수점 한 자리까지 표시합니다. 처음에는 f"{변수}" 형태만 익힌 뒤 필요한 출력 모양을 하나씩 추가해도 충분합니다.
문자열도 for문으로 한 글자씩 반복할 수 있다
문자열은 글자가 순서대로 이어진 값이므로 for문으로 한 글자씩 꺼낼 수 있습니다.
word = "Python"

for letter in word:
print(letter)P
y
t
h
o
nrange()를 만들거나 인덱스를 직접 증가시키지 않아도 됩니다. 글자 자체가 필요할 때는 문자열에서 바로 한 글자씩 꺼내는 방식이 더 읽기 쉽습니다.
text = "banana"
count = 0

for letter in text:
    if letter == "a":
        count += 1

print(f"a의 개수: {count}")a의 개수: 3앞에서 배운 반복문, 조건문, 누적 계산과 f-string을 한 예제에서 함께 사용했습니다.
자주 하는 실수
마지막 인덱스를 len()과 같다고 생각하는 경우
길이가 6인 문자열의 인덱스는 0부터 5까지입니다. 마지막 글자는 text[-1]로 가져오면 간단합니다.
슬라이싱의 끝값도 포함된다고 생각하는 경우
text[1:4]는 1, 2, 3번 글자를 가져옵니다. 끝값 4는 포함하지 않습니다.
문자열 메서드가 원본을 직접 바꾼다고 생각하는 경우
strip(), replace(), lower()는 결과로 새 문자열을 반환합니다. 필요한 경우 결과를 변수에 저장합니다.
f를 빠뜨리는 경우
name = "민수"
print("{name}님, 안녕하세요.")따옴표 앞에 f가 없으면 {name}이 변수의 값으로 바뀌지 않고 그대로 출력됩니다.
직접 바꿔 보며 확인하기
다음 문제를 직접 작성해 보세요.
- 좋아하는 단어의 첫 글자, 마지막 글자와 길이를 출력합니다.
"2026-08-12"에서 연도, 월, 일을 슬라이싱으로 나눕니다.- 입력받은 문장의 양끝 공백을 제거하고 소문자로 바꿉니다.
- 파일 이름을 입력받아
.py로 끝나는지 확인합니다. - 이름과 가격, 수량을 변수에 저장하고 총액을
f-string으로 출력합니다. - 문자열에서 특정 글자가 몇 번 나오는지
for문과 조건문으로 셉니다.
결과만 확인하기보다 인덱스 번호를 종이에 적어 보고, 슬라이싱의 시작과 끝 경계를 직접 표시해 보세요. 끝값을 하나씩 바꿔 보면 포함되는 글자가 어떻게 달라지는지 금방 감을 잡을 수 있습니다.
정리
문자열은 글자가 순서대로 이어진 변경 불가능한 값입니다. len()은 글자 수를 알려 주고, 인덱싱은 위치 번호로 글자 하나를, 슬라이싱은 시작부터 끝 직전까지의 구간을 가져옵니다.
strip(), replace(), lower() 같은 메서드는 원본을 직접 바꾸지 않고 새 문자열을 반환합니다. startswith(), endswith()는 문자열의 모양을 확인해 조건문과 연결하기 좋습니다.
f-string은 변수와 계산 결과를 읽기 쉬운 문장 안에 넣어 줍니다. 문자열은 for문으로 한 글자씩 반복할 수도 있으므로 지금까지 배운 조건문과 반복문을 텍스트 처리에 활용할 수 있습니다.
다음 글에서는 여러 값을 하나의 이름으로 묶어 순서대로 관리하는 리스트와 튜플을 알아보겠습니다. 문자열과 마찬가지로 인덱싱과 슬라이싱을 사용할 수 있지만, 값을 바꿀 수 있는지와 복사할 때 어떤 차이가 생기는지를 이어서 살펴보겠습니다.
참고 자료
'파이썬(Python)' 카테고리의 다른 글
| [Python(파이썬)] 딕셔너리 사용법과 set 중복 제거, 한 번에 이해하기 (0) | 2026.08.14 |
|---|---|
| [Python(파이썬)] 리스트와 튜플 차이? 추가·삭제·복사까지 쉽게 이해하기 (0) | 2026.08.13 |
| [Python(파이썬)] while문이란? 종료 조건과 break·continue 쉽게 이해하기 (0) | 2026.08.11 |
| [Python(파이썬)] for문이란? range()와 누적 계산 쉽게 이해하기 (0) | 2026.08.10 |
| [Python(파이썬)] 조건문이란? if·elif·else와 중첩 조건 쉽게 이해하기 (0) | 2026.08.09 |
